このブログの統計情報によるとこの1週間の参加者は下のようになっている。
インドやポーランドから見にきている方が結構いらっしゃるみたいだ。その前の週まではこれらの国からのアクセスは無かったので、DDR2の検索でたどり着いたのかな?
こうやって世界と繋がっていくのかしら。
何だか面白い。とりあえず挨拶でもしておくか。
やっほー、インドの皆さんみてるぅ? (^-^)/""
Hello world, I'm here (^-^)/""
2010年11月3日水曜日
MULTIPORT I/F部の検討
MULTIPORT I/F MODULEとCLIENT MODULE間のI/Fの検討を行った。
以下のようにしようと考えている。
と言っても今のところCLIENT MODULEはCAMERA I/FとDVIに出力するDISPLAY I/Fだけだ。んがっ、将来的には他のIPも作成し追加して行きたいので、ちょっと大袈裟かも知れないがこの様な仕様で行こうかと思う。問題はSpartan3A 700Aに全てのタイミングを満たした上で入るかどうかだ。。
以下のようにしようと考えている。
と言っても今のところCLIENT MODULEはCAMERA I/FとDVIに出力するDISPLAY I/Fだけだ。んがっ、将来的には他のIPも作成し追加して行きたいので、ちょっと大袈裟かも知れないがこの様な仕様で行こうかと思う。問題はSpartan3A 700Aに全てのタイミングを満たした上で入るかどうかだ。。
2010年10月31日日曜日
DDR2 SDRAM controller
ようやくDDR2 SDRAM controllerのcore module のRTLが出来た。
作成しているcontrollerは以下のような構造になっている。
←この部分がcore moduleになる。
clock domain はbf_clk (bus i/f clock)、wr_clk系、rd_clk系の3つだ。
CMD QUEUE, WDT QUEUEは非同期FIFOでここでclockの乗換も兼ねている。非同期FIFOの為同期損が発生し、同期式の場合と比べてlatencyが増加してしまうが反面bus i/f側と異なる周波数に出来るので全体的な設計は容易になると考えている。また、非同期FIFOはPHY_DPにも存在する。これはread data用である。
BCはbank controllerだ。本設計ではbank単位でpage管理を行おうと考えているので4つある。CPはcommand path controllerでBCからのaccess要求を調停して勝者の要求を実効する。各BCからCPへの要求信号はhreqとlreqがあり、Bank ActiveやPrecharge等の要求はhreqに、readやwriteの要求はlreqに出す。信号名からも自明なようにhreqの方が優先度は高く、CPはhreqの方を優先して処理する。
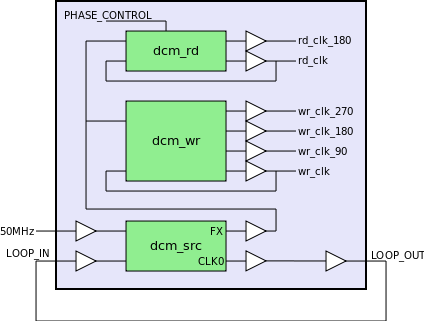
また、単にmodule構成の話ではあるが、wr_clk, rd_clkを作るDCM部はcore module内に持つことにした。その構成は今のところ以下の方針でいこうと考えている。
dcm_srcで周波数を作り、dcm_wr, dcm_rdで位相を作る。
dcm_srcのfeed back pathはSpartan3A Starter KitではLOOP_OUTとLOOP_INというそれ用と思われる配線があるのでその経路を使うことにした。(Starter Kitのdemoの設計資料は回路図とUCFファイル以外は参照していない。)
まだ実機動作はおろか合成すらしていないのでもしかしたら修正になるかも知れないが。。。
Micronのweb siteからsimulation modelを入手してsimulationにも着手した。
これはbank0,1,2,3へのwriteが連続する場合だ。各bankのpageは閉じている状態から始めている。上述の通りBCからCPへの要求はhreqが優先されるため、各bankのactiveが連続して実行され、その後writeが連続して実行される。SD_DQ, SD_DMの初めの部分に不定がのっている(赤くなっている)のは非同期FIFO内のRAMの初期値が不定の為であり、設計不良によるものではない。
これは同一bankへの連続writeの場合だ。本設計の用途はframe bufferとしてのものなので上記のような各bankへのaccessが連続するよりも左のような単一bankへのaccessが連続する方がより現実的だろう。もちろん論理addressをDRAMのaddressにどう対応づけるかにもよるが。。。また、波形から、write latencyは12だ。(bank activeから始まる場合、bank がactiveな状態ではもっと少なくなる。)Command queueが同期FIFOであれば2cycle程度は減る筈だが上述のような理由のためやむを得ない。
これは同一bankからの連続readの場合だ。bankがactiveの状態で開始しているのでread latencyは最小の場合だ。波形から17だ。
readではCommand queue部の同期損にPHY_DP部の非同期FIFOの同期損が加わるためlatencyは悪化してしまう。また、上述のlatency値はcore moduleのみの値であるがaccessを要求する側から見れば、MULTI PORT I/F部のlatencyも加味されることになる。
2010年10月29日金曜日
神のBIN2BCD
BIN2BCDについてネットで検索していたら凄いのを見つけてしまった。
このサイトだ。 (※. リンク先のサイトが存在しなくなっていたのでリンクを削除しました。 2016.09.19)
ここに引用しておく。
~~ 引用ここから ~~
module bin2bcd_m16
(
input wire [15:0] bin_in, // binary number in
output wire [15:0] bcd_out // BCD digits out
);
reg [3:0] ones, tens, huns, thous;
integer i;
assign bcd_out[3:0] = ones;
assign bcd_out[7:4] = tens;
assign bcd_out[11:8] = huns;
assign bcd_out[15:12] = thous;
always @(*) begin
thous = 0;
huns = 0;
tens = 0;
ones = 0;
for(i=15; i>=0; i=i-1) begin
{thous, huns, tens, ones} = {thous[2:0],huns,tens,ones,bin_in[i]};
if(ones >= 5 && i > 0) ones = ones + 3;
if(tens >= 5 && i > 0) tens = tens + 3;
if(huns >= 5 && i > 0) huns = huns + 3;
if(thous >= 5 && i > 0) thous = thous + 3;
end
end
endmodule
なんと、これでBinaryからBCDへの変換が出来るようだ。
コーディングの仕方は教科書では決して推奨されないスタイルだけれども凄い。
こんなんでちゃんと合成できるんだろうか?
ISEで合成してみた。。
ちゃんと合成できた。
シミュレーションをしてみた。
テストベンチは以下のようにした。
RTLとP&R後のネットリストの両方に同じ値を入力して、テストベンチ内部で生成した期待値と両者の出力が一致するかを見ている。
`timescale 1ns/1ps
module tb;
reg clk;
reg [15:0] bin_in;
wire [15:0] bcd_rtl,bcd_map;
reg [3:0] d3,d2,d1,d0;
integer r,err;
bin2bcd_m16 i_rtl ( .bin_in (bin_in), .bcd_out(bcd_rtl));
bin2bcd_m16_map i_map ( .bin_in (bin_in), .bcd_out(bcd_map));
initial begin
clk = 0;
forever clk = #5 ~clk;
end
initial begin
bin_in = 0;
err = 0;
wait (!glbl.GSR);
@(posedge clk); #1;
@(posedge clk); #1;
for (bin_in = 0; bin_in < 10000; bin_in = bin_in + 1)
begin
@(posedge clk); #1;
d3 = bin_in / 1000;
r = bin_in % 1000;
d2 = r / 100;
r = r % 100;
d1 = r / 10;
d0 = r % 10;
if ((bcd_rtl !== {d3,d2,d1,d0}) ||
(bcd_map !== {d3,d2,d1,d0}) ||
(bcd_map !== bcd_rtl)) begin
$display("ERROR!!! in=%d,exp=%x->rtl=%x,map=%x",
bin_in,{d3,d2,d1,d0}, bcd_rtl, bcd_map);
err = err+1;
end else begin
$display("O K !!! in=%d,exp=%x->rtl=%x,map=%x",
bin_in,{d3,d2,d1,d0}, bcd_rtl, bcd_map);
end
end
if (err == 0)
$display("END OF SIMULATION WITH NO ERROR");
else
$display("END OF SIMULATION WITH %d ERROR(S)", err);
$finish;
end
endmodule
icarus verilogでsimulationした。

エラーなし!! 凄い!!
こういうアルゴリズムをサクッと創造できるようになりたいもんだ。
私にとってみると正に神のBIN2BCDだ。
すげ~、凄い、凄すぎます。きゃ~~興奮しちゃう。
私もDRAMCの作成を頑張ろう。
ここに引用しておく。
~~ 引用ここから ~~
module bin2bcd_m16
(
input wire [15:0] bin_in, // binary number in
output wire [15:0] bcd_out // BCD digits out
);
reg [3:0] ones, tens, huns, thous;
integer i;
assign bcd_out[3:0] = ones;
assign bcd_out[7:4] = tens;
assign bcd_out[11:8] = huns;
assign bcd_out[15:12] = thous;
always @(*) begin
thous = 0;
huns = 0;
tens = 0;
ones = 0;
for(i=15; i>=0; i=i-1) begin
{thous, huns, tens, ones} = {thous[2:0],huns,tens,ones,bin_in[i]};
if(ones >= 5 && i > 0) ones = ones + 3;
if(tens >= 5 && i > 0) tens = tens + 3;
if(huns >= 5 && i > 0) huns = huns + 3;
if(thous >= 5 && i > 0) thous = thous + 3;
end
end
endmodule
~~ 引用ここまで ~~
なんと、これでBinaryからBCDへの変換が出来るようだ。
コーディングの仕方は教科書では決して推奨されないスタイルだけれども凄い。
こんなんでちゃんと合成できるんだろうか?
ISEで合成してみた。。
ちゃんと合成できた。
シミュレーションをしてみた。
テストベンチは以下のようにした。
RTLとP&R後のネットリストの両方に同じ値を入力して、テストベンチ内部で生成した期待値と両者の出力が一致するかを見ている。
`timescale 1ns/1ps
module tb;
reg clk;
reg [15:0] bin_in;
wire [15:0] bcd_rtl,bcd_map;
reg [3:0] d3,d2,d1,d0;
integer r,err;
bin2bcd_m16 i_rtl ( .bin_in (bin_in), .bcd_out(bcd_rtl));
bin2bcd_m16_map i_map ( .bin_in (bin_in), .bcd_out(bcd_map));
initial begin
clk = 0;
forever clk = #5 ~clk;
end
initial begin
bin_in = 0;
err = 0;
wait (!glbl.GSR);
@(posedge clk); #1;
@(posedge clk); #1;
for (bin_in = 0; bin_in < 10000; bin_in = bin_in + 1)
begin
@(posedge clk); #1;
d3 = bin_in / 1000;
r = bin_in % 1000;
d2 = r / 100;
r = r % 100;
d1 = r / 10;
d0 = r % 10;
if ((bcd_rtl !== {d3,d2,d1,d0}) ||
(bcd_map !== {d3,d2,d1,d0}) ||
(bcd_map !== bcd_rtl)) begin
$display("ERROR!!! in=%d,exp=%x->rtl=%x,map=%x",
bin_in,{d3,d2,d1,d0}, bcd_rtl, bcd_map);
err = err+1;
end else begin
$display("O K !!! in=%d,exp=%x->rtl=%x,map=%x",
bin_in,{d3,d2,d1,d0}, bcd_rtl, bcd_map);
end
end
if (err == 0)
$display("END OF SIMULATION WITH NO ERROR");
else
$display("END OF SIMULATION WITH %d ERROR(S)", err);
$finish;
end
endmodule
icarus verilogでsimulationした。

エラーなし!! 凄い!!
こういうアルゴリズムをサクッと創造できるようになりたいもんだ。
私にとってみると正に神のBIN2BCDだ。
すげ~、凄い、凄すぎます。きゃ~~興奮しちゃう。
私もDRAMCの作成を頑張ろう。
2010年10月27日水曜日
BIN2BCD
ブログFPGAの部屋の今日の記事は2進数からBCDへの変換回路だった。
おもしろそうなので、私も検討してみた。
私の場合はこうするかな?
module bin2bcd (clk, bin, bcd);
input clk;
input [ 9:0] bin;
output [15:0] bcd;
wire [13:0] k3;
reg [13:0] k3b;
reg [ 3:0] d32;
reg [ 3:0] d31;
reg [ 3:0] d30;
wire [13:0] k2;
reg [13:0] k2b;
reg [ 3:0] d21;
reg [ 3:0] d20;
wire [13:0] k1;
reg [ 3:0] d10;
reg [ 3:0] d00;
assign k3 = bin + bin[9:6] + bin[9:7] + bin[9] + 1'b1;
always @(posedge clk) d32 <= k3[13:10];
always @(posedge clk) k3b <= bin - (k3[13:10] * 1000);
assign k2 = k3b * 10 + k3b[13:2];
always @(posedge clk) d21 <= k2[13:10];
always @(posedge clk) k2b <= k3b - (k2[13:10] * 100);
always @(posedge clk) d31 <= d32;
assign k1 = k2b * 102 + k2b[13:1];
always @(posedge clk) d00 <= k2b - (k1[13:10] * 10);
always @(posedge clk) d10 <= k1[13:10];
always @(posedge clk) d20 <= d21;
always @(posedge clk) d30 <= d31;
assign bcd = {d30,d20,d10,d00};
endmodule
パイプライン式でLatencyは3だけど乗算部が5つもある。
y = -ax+b , y = a x+b部を1つにしてステートマシンで回すようにすればもう少しコンパクトにできるかも知れないな。
2010年10月26日火曜日
PHY部の検討
DDR2 SDRAM CONTROLLERのPHY部に検討を行っている。
Spartan3AはIDELAYを持っているが、IOB内部のF/Fを使用する場合は4tapしか使えず自由度が低い。Spartan3Aではread dataの取り込みはDQSの位相をずらして使用するのではなく、DCMでCapture用のclockを生成して使うのが作法のようだ。その作法に則って設計することにしよう。
Write系のData pathは以下のようにした。
//--------------------------------------------------------------------------------
// circuit description
//--------------------------------------------------------------------------------
OBUF i_obuf_dm [(PHYDMW/2)-1:0] (
.O( DM ),
.I( dmo )
);
IOBUF i_iobuf_dq [(PHYDW/2)-1:0] (
.IO( DQ ),
.O ( dqi),
.I ( dqo),
.T ( oen)
);
IOBUFDS i_iobufds_dqs [(PHYDW/16)-1:0] (
.IO ( DQS_P),
.IOB( DQS_N),
.O ( dqsi ),
.I ( dqso ),
.T ( oen )
) ;
//--------------------------------------------------------------------------------
// write
//--------------------------------------------------------------------------------
/*********************************************************************************
tx_clk_270 ~~|___|~~~|___|~~~|___|~~~|___|~~~|___|~~~|___|~~~|_
tx_clk_180 |___|~~~|___|~~~|___|~~~|___|~~~|___|~~~|___|~~~|___
tx_clk_90 __|~~~|___|~~~|___|~~~|___|~~~|___|~~~|___|~~~|___|~
tx_clk ___|~~~|___|~~~|___|~~~|___|~~~|___|~~~|___|~~~|___|~~~
: : : : : : : : : : : : : : : : : : : : : : : : : :
dp_ten ____/~~~~~~~~~~~~~~~~\_________________________________
dp_ten_1d __________/~~~~~~~~~~~~~~~~\_________________________
ten_pd __________________/~~~~~~~~~~~~~~~~\_________________
ten_nd ________________/~~~~~~~~~~~~~~~~\___________________
: : : : : : : : : : : : : : : : : : : : : : : : : :
oen __________/~~~~~~~~~~~~~~~~~~~~~~~~\_________________
dqso_en __________/~~~~~~~~~~~~~~~~~~~~~~\___________________
DQS ----------_______|~~~|___|~~~|_____------------------
: : : : : : : : : : : : : : : : : : : : : : : : : :
tx_clk_90 __|~~~|___|~~~|___|~~~|___|~~~|___|~~~|___|~~~|___|~
___ _______ _______ _______ _______ _______ _______ __
dp_wd ___X__Va___X__Vb___X_______X_______X_______X_______X__
______ _______ _______ _______ _______ _______ ______
wd_180 ______X__Va___X__Vb___X_______X_______X_______X______
____ _______ _______ _______ _______ _______ _______
wd_90 ____X_______X___Va__X__Vb___X_______X_______X_______X
___ ___ ___ ___
DQ -----------#####X_a_X_a_X_b_X_b_X####-----------------
: : : : : : : : : : : : : : : : : : : : : : : : : :
___ ___ ___ ___
DQ -----------#####X_a_X_a_X_b_X_b_X####-----------------
: : : : : : : : : : : : : : : : : : : : : : : : : :
DQS ----------_______|~~~|___|~~~|_____------------------
latency = 2
*********************************************************************************/
FDC i_ten_1d (.C(tx_clk ),.D(dp_ten ),.Q(dp_ten_1d),.CLR(tx_rst));
FDC i_ten_pd (.C(tx_clk ),.D(dp_ten_1d),.Q(ten_pd ),.CLR(tx_rst));
FDC i_ten_nd (.C(tx_clk_270),.D(dp_ten_1d),.Q(ten_nd ),.CLR(tx_rst));
NOR2 i_nor_oen (.I0(ten_pd), .I1(dp_ten_1d), .O(oen ));
NOR2 i_nor_dqso_en (.I0(ten_nd), .I1(dp_ten_1d), .O(dqso_en));
OR2 i_or_dqo_en (.I0(ten_nd), .I1(dp_ten_1d), .O(dqo_en));
ODDR2 #(
.DDR_ALIGNMENT( "NONE" ),
.INIT ( 1'b0 ),
.SRTYPE ( "ASYNC" )
) i_oddr_dqso [(PHYDW/16)-1:0] (
.CE ( 1'b1 ),
.R ( dqso_en ),
.S ( 1'b0 ),
.Q ( dqso ),
.C0 ( tx_clk_180 ),
.C1 ( tx_clk ),
.D1 ( 1'b1 ),
.D0 ( 1'b0 )
);
FD i_fd_wd_180 [PHYDW-1 :0] (.C(tx_clk_180), .D(dp_wd ), .Q(wd_180 ));
FD i_fd_wdm_180 [PHYDMW-1:0] (.C(tx_clk_180), .D(dp_wdm ), .Q(wdm_180));
FD i_fd_wd_90 [PHYDW-1 :0] (.C(tx_clk_90 ), .D(wd_180 ), .Q(wd_90 ));
FD i_fd_wdm_90 [PHYDMW-1:0] (.C(tx_clk_90 ), .D(wdm_180), .Q(wdm_90 ));
ODDR2 # (
.DDR_ALIGNMENT( "NONE" ),
.INIT ( 1'b0 ),
.SRTYPE ( "ASYNC" )
) i_dqo_ddr[(PHYDW/2)-1:0] (
.CE ( dqo_en ),
.R ( 1'b0 ),
.S ( 1'b0 ),
.Q ( dqo ),
.C0 ( tx_clk_270 ),
.D0 ( wd_90[ 7:0] ),
.C1 ( tx_clk_90 ),
.D1 ( wd_90[15:8] )
) ;
ODDR2 # (
.DDR_ALIGNMENT( "NONE" ),
.INIT ( 1'b0 ),
.SRTYPE ( "ASYNC" )
) i_dmo_ddr [(PHYDMW/2)-1:0] (
.CE ( dqo_en ),
.R ( 1'b0 ),
.S ( 1'b0 ),
.Q ( dmo ),
.C0 ( tx_clk_270 ),
.C1 ( tx_clk_90 ),
.D1 ( wdm_90[1] ),
.D0 ( wdm_90[0] )
) ;
また、Read系は以下だ。
//--------------------------------------------------------------------------------
// read
//--------------------------------------------------------------------------------
IDDR2 #(
.DDR_ALIGNMENT( "NONE" ),
.SRTYPE ( "ASYNC" ),
.INIT_Q0 ( 1'b0 ),
.INIT_Q1 ( 1'b0 )
)
i_ddr [(PHYDW/2)-1:0] (
.C0 ( rx_clk_180 ),
.C1 ( rx_clk ),
.D ( dqi ),
.Q1 ( dqip ),
.Q0 ( dqin ),
.CE ( 1'b1 ),
.S ( 1'b0 ),
.R ( 1'b0 )
);
wire dp_ren_dly;
FDC i_ren_dly1 (.C (rx_clk),.D(dp_ren),.Q(dp_ren_dly),.CLR(rx_rst));
FDC i_ren_dly2 (.C (rx_clk),.D(dp_ren_dly),.Q(af_wen),.CLR(rx_rst));
afifo #(.DW(PHYDW), .AW(3)) i_asq (
.wclk (rx_clk ),
.wrst (tx_rst ),
.full (/* open */ ),
.amfull (/* open */ ),
.wen (af_wen ),
.wdt ({dqin,dqip}),
.rclk (bf_clk ),
.rrst (bf_rst ),
.empty (asq_empty ),
.ren (dp_rd_rdy ),
.rdt (pd_rd )
);
INV i_vld (.I(asq_empty),.O(pd_rd_vld));
Icarus Verilogでsimulationを行った。
Write系
Read系は上記Write dataを折り返して確認した。
2010年10月22日金曜日
2010年10月21日木曜日
色味の調整3
2010年10月20日水曜日
調整用プログラム
調整用プログラムをwxWidgetsで作った。
カラーバーの画面を見ながら各スライダーを動かして最適ポイントに合わせようというスンポウだ。
が、中々最適ポイントにならない。
←は一見ばらつきも少なくいい感じのように見えるが、FPGA内部で生成したパターンよりも振幅が大きくサチってる感じだ。
カメラのテストパターンをRamp2にして見ると左の通りでやはり飽和していた。
カラーバーの画面を見ながら各スライダーを動かして最適ポイントに合わせようというスンポウだ。
が、中々最適ポイントにならない。
←は一見ばらつきも少なくいい感じのように見えるが、FPGA内部で生成したパターンよりも振幅が大きくサチってる感じだ。
カメラのテストパターンをRamp2にして見ると左の通りでやはり飽和していた。
2010年10月19日火曜日
色味の調整2
R,G,B各成分の振幅をグラフ表示するようにしてみた。
← 横一直線に並んでいるのはFPGAで生成したカラーバーのもの。上下に散らばっているのはカメラのカラーバーだ。
この画面を見ながらカメラのレジスタ値を調整していけば判りやすいのではないかと考えているが。。。旨くいくかな?
← 横一直線に並んでいるのはFPGAで生成したカラーバーのもの。上下に散らばっているのはカメラのカラーバーだ。
この画面を見ながらカメラのレジスタ値を調整していけば判りやすいのではないかと考えているが。。。旨くいくかな?
登録:
投稿 (Atom)
ERROR: Failed to spawn fakeroot worker to run ...
なにかと忙しくてなかなか趣味の時間を確保できない。 ...orz 家の開発機のOSはLinux Mintなのだが、最近バージョンを22に更新したところ、myCNC用のpetalinuxをビルドできなくなってしまった。ビルドの途中で ERROR: Failed to spawn ...
-
FT232RというUSB-UART変換ICがある。このICにはBit Bang Modeという機能があって、UART用の端子がGPIO的制御が可能になる。 FT232Rを搭載したUSB-UART変換基板は秋月電子やマルツパーツ等色んなところで売られていて私もSparkfunのF...
-
これまではTCM8230MDの出力形式はRGB565にしていたが、画像もちゃんと表示できるようになってきたのでYUV422形式も扱えるようにして両者の画像の違いを見てみた。 まずTCM8230MDの出力をcolor bar出力にして、取り込んだ値に変換式を適用してどんな感じの...